Страница с 200 OK, self-canonical, Sitemap и уникальным текстом всё равно может остаться вне индекса. Google и Яндекс сначала находят и обрабатывают URL, затем отдельные алгоритмы решают, нужен ли этот документ в поисковой базе. Для SEO-диагностики полезно разделять проблемы обнаружения, обхода, рендеринга, индексируемости, каноникализации и алгоритмического отбора.
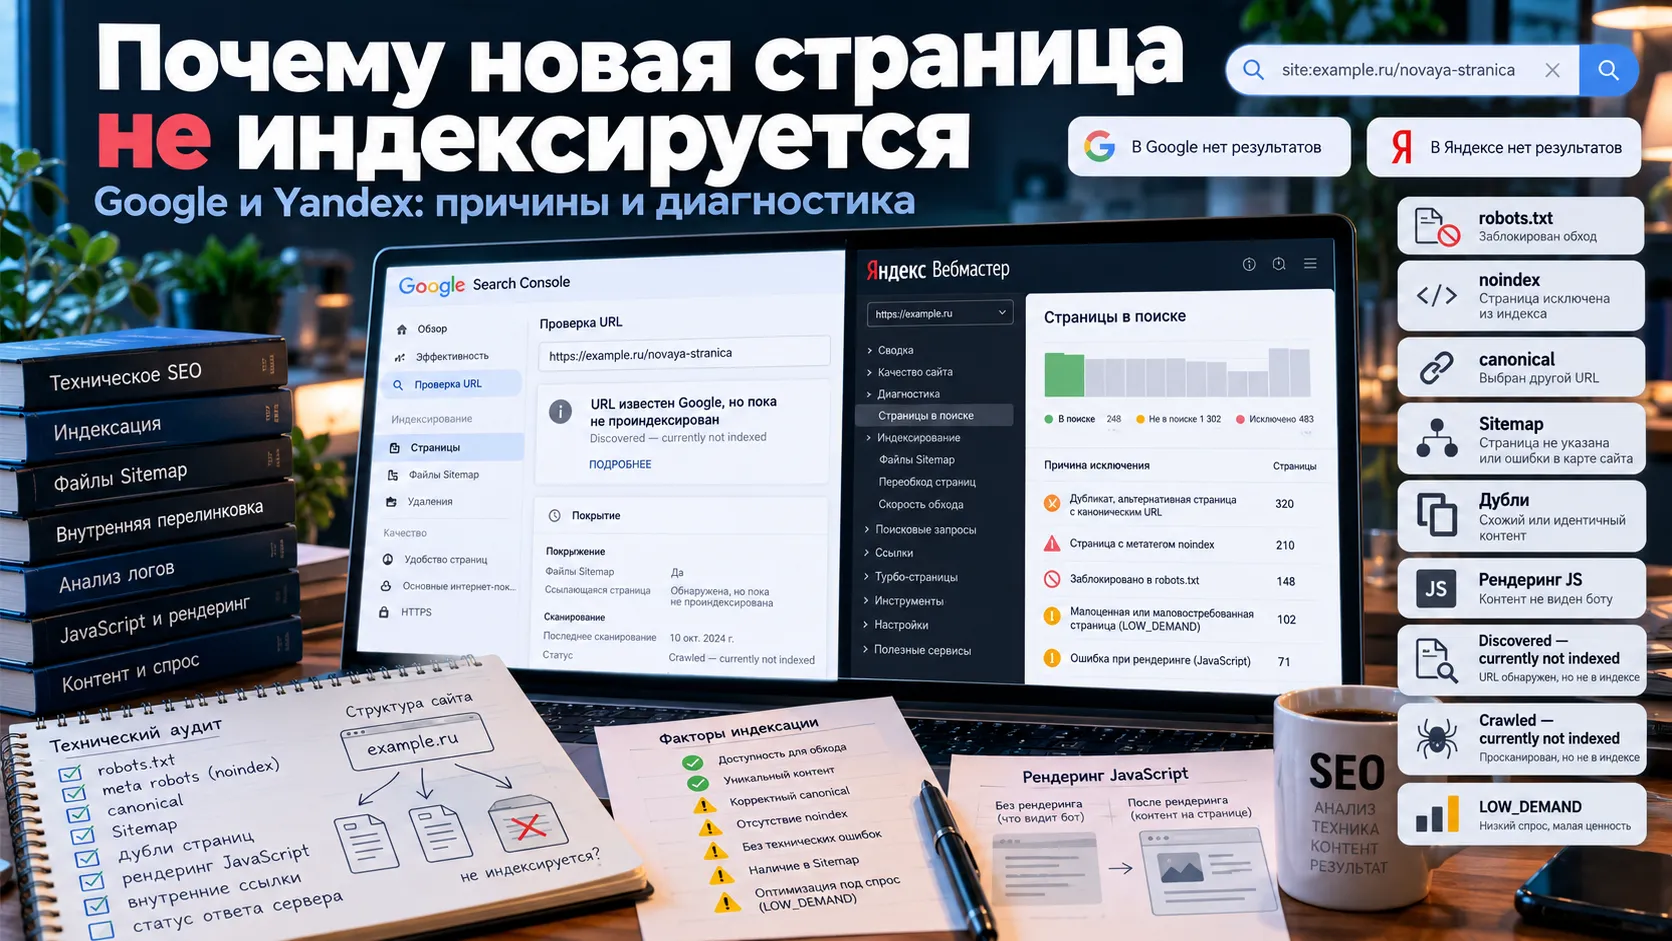
Индексирование состоит из нескольких независимых этапов
У SEO-специалиста часто возникает логичная реакция: страница открывается, текст большой и информативный, title заполнен, URL отправлен через Search Console или Яндекс Вебмастер — значит, документ должен появиться в поиске. Механика поисковых систем устроена сложнее.
Google описывает три базовых этапа: crawling, indexing и serving. Сначала Googlebot узнаёт об URL и загружает страницу, затем Google обрабатывает содержимое и решает вопрос с индексом, после чего индексированный документ может участвовать в формировании результатов. Google прямо указывает, что соблюдение технических требований не гарантирует сканирование, индексирование или показ конкретной страницы.
У Яндекса логика близкая. Робот обнаруживает страницу, загружает и обрабатывает данные, затем алгоритмы формируют базу документов, которые могут участвовать в поиске. Яндекс отдельно указывает, что оригинальный структурированный текст может остаться вне поисковой базы, если алгоритм оценивает вероятность его полезного показа как низкую.
Для диагностики здесь полезно разделять этапы. Доступность URL для робота подтверждает только часть цепочки. Решение об индексировании принимается позже.
В нашем блоге мы уже публиковали отдельный материал про управление индексацией пагинации, тегов и категорий. Там подробно разобраны robots.txt, noindex, canonical и служебные URL. Здесь фокус другой: отдельная новая статья или посадочная страница технически открыта, поисковик её знает; документ всё равно остаётся вне индекса.
HTTP 200, robots, noindex и canonical формируют первый слой проверки
Первая задача — понять, может ли робот получить именно тот документ, который видит пользователь. Код 200 OK нужен для обычной индексируемой страницы. Сам по себе он сообщает только об успешной отдаче ответа сервером.
| Сигнал | Что видит поисковик | Типичный риск |
200 OK | Сервер успешно отдаёт URL | Контент может оказаться слабым, пустым после рендеринга или дублирующим |
robots.txt: Disallow | Обход URL ограничен | Робот не получает содержимое страницы или получает его реже |
<meta name="robots" content="noindex"> | Страница закрыта от индекса | URL исключается из поиска после обработки директивы |
rel="canonical" на другой URL | Другой адрес заявлен основной версией | Текущий URL может считаться дублем или альтернативой |
301/302 | Документ перенаправляет робота | В индекс обычно рассматривается конечный URL |
200 OK на странице ошибки | Возможен soft 404 | Поисковик может отказаться индексировать документ |
| Контент появляется только после JavaScript | Нужен этап рендеринга | Ошибка скрипта или недоступный ресурс может оставить роботу пустую страницу |
Особое внимание требуется к сочетанию robots.txt и noindex. Google должен получить страницу, чтобы прочитать noindex. Если URL одновременно закрыт через Disallow, Googlebot может не увидеть метатег. Для диагностики это разные механизмы: robots.txt управляет обходом, noindex — включением документа в индекс после доступного обхода.
Canonical тоже нельзя трактовать как формальность. Для Google rel="canonical" служит сильным сигналом. Окончательный canonical Google выбирает самостоятельно. В Search Console полезно сравнивать User-declared canonical и Google-selected canonical. У Яндекса страница, которую алгоритм считает неканонической, может получить отдельный статус исключения.
Самая неприятная техническая ситуация появляется, когда браузер показывает полноценный материал, а поисковый робот получает другую версию. Причиной бывают CDN, WAF, географические правила, различия по User-Agent, сбой SSR, недоступный API, JavaScript-ошибка или шаблон, который отдаёт оболочку без основного текста. В таких случаях визуальная проверка страницы человеком мало что доказывает.
Информативный текст ещё не создаёт обязательства для поисковой системы
После успешной технической проверки начинается сложная часть. Поисковик оценивает, есть ли причина хранить конкретный URL в своей базе.
Google в документации Search Console прямо пишет, что индексировать все URL сайта не требуется. Среди нормальных причин отсутствия страницы в индексе перечисляются дубли, фильтры и документы без достаточной самостоятельной ценности. В документации по сканированию Google отдельно указывает: страница может быть успешно просканирована и всё равно не показываться в поиске, если системе недостаточно её ценности или пользовательского спроса.
У Яндекса этот механизм виден ещё нагляднее через статус «Малоценная или маловостребованная страница». Алгоритм может исключить документ, когда он дублирует уже известный материал, не содержит видимого роботу контента или плохо соответствует запросам пользователей. Яндекс отдельно пишет, что похожие страницы могут отвечать на один и тот же запрос, после чего в поиске останется одна более релевантная версия.
Для редактора статья может выглядеть сильной: 7–10 тысяч знаков, таблица, изображения, FAQ, авторская подача. Для индексирующего алгоритма важен другой вопрос — какую отдельную поисковую задачу решает этот URL по сравнению с уже известными документами.
Тематическое дублирование возникает даже при полностью уникальном тексте
Проверка на процент текстовой уникальности почти ничего не говорит о необходимости отдельного URL в индексе. Два материала могут быть написаны разными словами и закрывать один поисковый интент.
Представим технологический блог, где уже опубликованы материалы «Что такое eSIM и как установить цифровую SIM-карту» и «eSIM в путешествиях — подключение и мобильный интернет за границей». Затем выходит новая публикация «Технология eSIM — устройство, установка и использование».
Новая статья может быть полностью оригинальной на уровне фраз. Семантическое ядро, набор сущностей и ожидаемые ответы частично повторяют первый материал: определение eSIM, совместимость, QR-код, активация, преимущества, ограничения. Для поисковой системы появляется вопрос, зачем хранить и ранжировать два близких документа одного сайта по одному набору запросов.
У Яндекса такой сценарий прямо описан в справке по малоценным и маловостребованным страницам: похожие документы могут конкурировать за один запрос, а алгоритм оставит более релевантный. У Google буквальные и очень близкие дубли проходят через каноникализацию. Если страница получает статус Crawled — currently not indexed, отчёт подтверждает успешный обход и отсутствие URL в индексе на момент обработки; полный набор причин такого отбора Google не раскрывает.
Разделение интента меняет картину. Отдельный материал про архитектуру eSIM может строиться вокруг EID, SM-DP+, профилей оператора, процесса загрузки и причин ошибок активации. Материал о связи в поездках может работать с географией, роумингом, объёмом трафика, сроками действия тарифа и совместимостью операторов. Поисковому алгоритму проще увидеть самостоятельную роль каждого URL, когда различается набор задач, сущностей и ожидаемых ответов.
Внутренняя перелинковка сообщает поисковику роль новой страницы
Наличие URL в Sitemap помогает поисковику узнать о странице. Sitemap не гарантирует её обход и индексирование. Google прямо называет карту сайта способом обнаружения URL. Включение документа в индекс остаётся отдельным решением. Яндекс рекомендует добавлять новые страницы в Sitemap и связывать их ссылками с уже известными страницами сайта.
Реалистичный сценарий выглядит так: статья опубликована, присутствует в sitemap.xml, получает 200 OK, self-canonical и index, follow. С главной страницы блога она быстро исчезла из ленты, тематическая категория находится глубоко, из старых статей на новый URL нет ссылок. Робот знает адрес по Sitemap. Внутренняя структура почти не объясняет значимость документа и его тематическое окружение.
Для Google это может проявиться статусом Discovered — currently not indexed: URL известен, полноценный обход ещё не состоялся. Если Google уже загрузил страницу, возможен статус Crawled — currently not indexed. В Яндекс Вебмастере картина может выглядеть как страница, известная роботу и отсутствующая в поиске либо попавшая в группу исключённых.
Внутренняя ссылка передаёт больше контекста, чем сам факт существования URL. Анкор, страница-донор, глубина клика, связь с категорией и соседними материалами формируют граф сайта, по которому поисковик понимает место документа среди остальных страниц.
Crawl budget объясняет часть задержек и редко служит универсальным диагнозом
Термин crawl budget часто используют как объяснение любой задержки индексации. У небольшого блога с сотнями или несколькими тысячами URL такой диагноз требует фактических подтверждений.
Google связывает интенсивность обхода с двумя группами ограничений: возможностями сервера и спросом на сканирование. Медленные ответы, ошибки 5xx, длинные цепочки редиректов, бесконечные пространства URL, фильтры и тысячи дублей расходуют ресурсы робота. На крупных сайтах это способно замедлять обнаружение и переобход полезных страниц.
Яндекс отдельно указывает, что дубли заставляют робота тратить время на повторяющиеся URL и могут замедлять поступление данных о действительно нужных страницах в поисковую базу.
Для небольшого сайта сначала полезнее искать конкретный статус страницы, технический запрет, слабую перелинковку, дублирование интента или недостаточную самостоятельную ценность. Серверные логи становятся особенно полезными, когда интерфейс вебмастера показывает, что URL давно известен, а реального обхода нет.
Статусы Search Console и Яндекс Вебмастера описывают разные стадии проблемы
Одинаковое внешнее проявление — страницы нет в поиске — может иметь совершенно разные причины.
| Система и статус | Что произошло | Основное направление диагностики |
Google — Discovered, currently not indexed | Google знает URL; полноценный обход ещё не выполнен | Обнаружение, внутренняя перелинковка, Sitemap, crawl demand, серверная доступность |
Google — Crawled, currently not indexed | Google загрузил URL и пока не включил его в индекс | Рендеринг, самостоятельная ценность, сходство с другими страницами, качество основного контента |
| Google — Duplicate, Google chose different canonical | Google объединил URL с другой версией | Canonical, редиректы, параметры, дубли и внутренние ссылки |
Google — Excluded by noindex | Google прочитал запрет на индексирование | Метатеги и X-Robots-Tag |
Яндекс — LOW_DEMAND | Алгоритм считает страницу малоценной или маловостребованной | Видимый контент, уникальная роль URL, соответствие реальным запросам |
Яндекс — DUPLICATE | Найден другой документ с тем же или близким содержимым | Дубли, параметры, структура URL, canonical |
Яндекс — NOT_CANONICAL | Для группы страниц выбрана другая каноническая версия | rel="canonical" и доступность указанного canonical |
Яндекс — META_NO_INDEX | На странице обнаружен запрет noindex | HTML-шаблон или HTTP-заголовок |
Яндекс — HTTP_ERROR / HOST_ERROR | Робот получил ошибку страницы или соединения | Сервер, CDN, firewall, DNS, временные сбои |
Самая частая ошибка в SEO-аудите — начинать улучшать текст до определения стадии, на которой страница выпала из цепочки. Если Google ещё не обходил URL, переписывание абзацев само по себе не устраняет проблему обнаружения. Если робот уже получил страницу и выбрал другой canonical, отправка того же URL на переиндексацию не меняет канонические сигналы.
Диагностика новой страницы работает лучше как последовательность проверок
Для страницы, которая должна участвовать в поиске, рабочая последовательность выглядит так:
- Проверить финальный HTTP-ответ для Googlebot и YandexBot: ожидается
200 OKбез неожиданных редиректов,403,404,429и5xx. - Сравнить исходный HTML и отрендеренную версию. В основном документе должны присутствовать H1, основной текст, внутренние ссылки и метаданные, которые поисковый робот реально получает.
- Проверить
robots.txt,meta robotsиX-Robots-Tag. Для индексируемой статьи не должно оставаться случайногоnoindex. - Проверить canonical. Для самостоятельной статьи типовой вариант — self-canonical; в Search Console отдельно смотрится canonical, выбранный Google.
- Проверить Sitemap и внутренние ссылки. Новый URL должен существовать в логичной структуре сайта, а не только в XML-файле.
- Сравнить страницу с уже индексируемыми материалами собственного сайта по интенту, сущностям, структуре ответа и целевым запросам.
- Проверить спрос и SERP. Если выдачу занимают документы другого типа или новый материал повторяет уже закрытый интент, проблема лежит глубже технических метатегов.
- Проверить серверные логи и даты последнего обхода, если интерфейсы поисковых систем показывают длительную задержку.
- После существенного изменения страницы отправить один запрос на переобход и оценивать новый статус после следующей обработки. Многократная отправка неизменённого URL не ускоряет Googlebot.
Эта последовательность помогает не смешивать разные классы проблем. Ошибка на уровне HTTP требует технического исправления. Ошибка canonical требует согласования сигналов. Статус Crawled — currently not indexed при чистой технической картине переводит анализ в область рендеринга, дублирования, интента и самостоятельной ценности документа.
Две похожие ситуации могут закончиться разным решением Google и Яндекса
Допустим, SEO-специалист публикует статью объёмом 3 500 слов. URL возвращает 200 OK, присутствует в Sitemap, canonical указывает на себя, текст виден без авторизации, страница связана с категорией и двумя тематическими статьями.
Через неделю Google Search Console показывает Crawled — currently not indexed. Яндекс уже добавил URL в поиск. Такая картина не доказывает ошибку Google и не подтверждает техническую проблему сайта. У систем разные индексы, расписание обхода, способы группировки похожих документов и алгоритмы отбора. Для Google конкретная страница могла оказаться слишком близкой к уже известному материалу или недостаточно полезной относительно существующего набора документов.
Второй сценарий: Google индексирует статью, Яндекс присваивает LOW_DEMAND. Яндекс прямо связывает этот статус с вероятностью востребованности страницы и соответствием пользовательским запросам. Технически исправный URL может оставаться вне его поисковой базы без санкций для всего сайта.
Разница между системами особенно заметна на новых информационных материалах. Сам факт индексирования одним поисковиком не создаёт обязательства для другого.
Повторная отправка URL не заменяет изменение сигнала
Search Console позволяет запросить индексирование через URL Inspection, Яндекс Вебмастер — отправить страницу на переобход. Эти инструменты сообщают поисковой системе о URL или изменении. Они не отменяют каноникализацию, не создают спрос и не превращают близкий по смыслу документ в самостоятельный результат.
Google предупреждает, что повторные запросы для одного неизменённого URL не ускоряют обход. Запрос на переиндексацию тоже не гарантирует включение страницы в поиск. У Яндекса решение по малоценным и маловостребованным страницам регулярно пересматривается алгоритмом, когда робот получает обновлённое содержимое.
Поэтому статус после переобхода важнее самого факта нажатия кнопки. Если URL снова возвращается в Crawled — currently not indexed или LOW_DEMAND, это уже устойчивый сигнал для анализа содержимого, роли страницы и её отношений с другими документами сайта.
Индексирование отражает место страницы внутри всего поискового корпуса
Новая страница может быть технически исправной, содержательной и полезной для части аудитории, оставаясь вне Google или Яндекса. Поисковые системы оценивают документ в контексте уже известных URL, запросов, дублей, канонических сигналов, структуры сайта и собственных ресурсов на обход и хранение.
Поэтому одинаковый симптом «статья не индексируется» объединяет несколько разных процессов: робот мог ещё не дойти до URL, мог получить неполный документ, мог выбрать другой canonical, мог объединить страницу с похожей или мог решить, что отдельный результат не нужен в текущей поисковой базе.
Граница между технической ошибкой и алгоритмическим отбором остаётся главным источником неопределённости. Search Console и Яндекс Вебмастер показывают часть причин. Полный набор сигналов, по которым конкретный документ включается в индекс или исключается из него, остаётся закрытым.