Каннибализация контента возникает, когда несколько страниц сайта борются за одни и те же поисковые запросы и решают одинаковую задачу пользователя. Проверка запросов, URL и назначения каждой страницы помогает выяснить, какие материалы объединить, какие переработать, а какие оставить самостоятельными.
Несколько страниц могут отвечать на один запрос и мешать продвижению
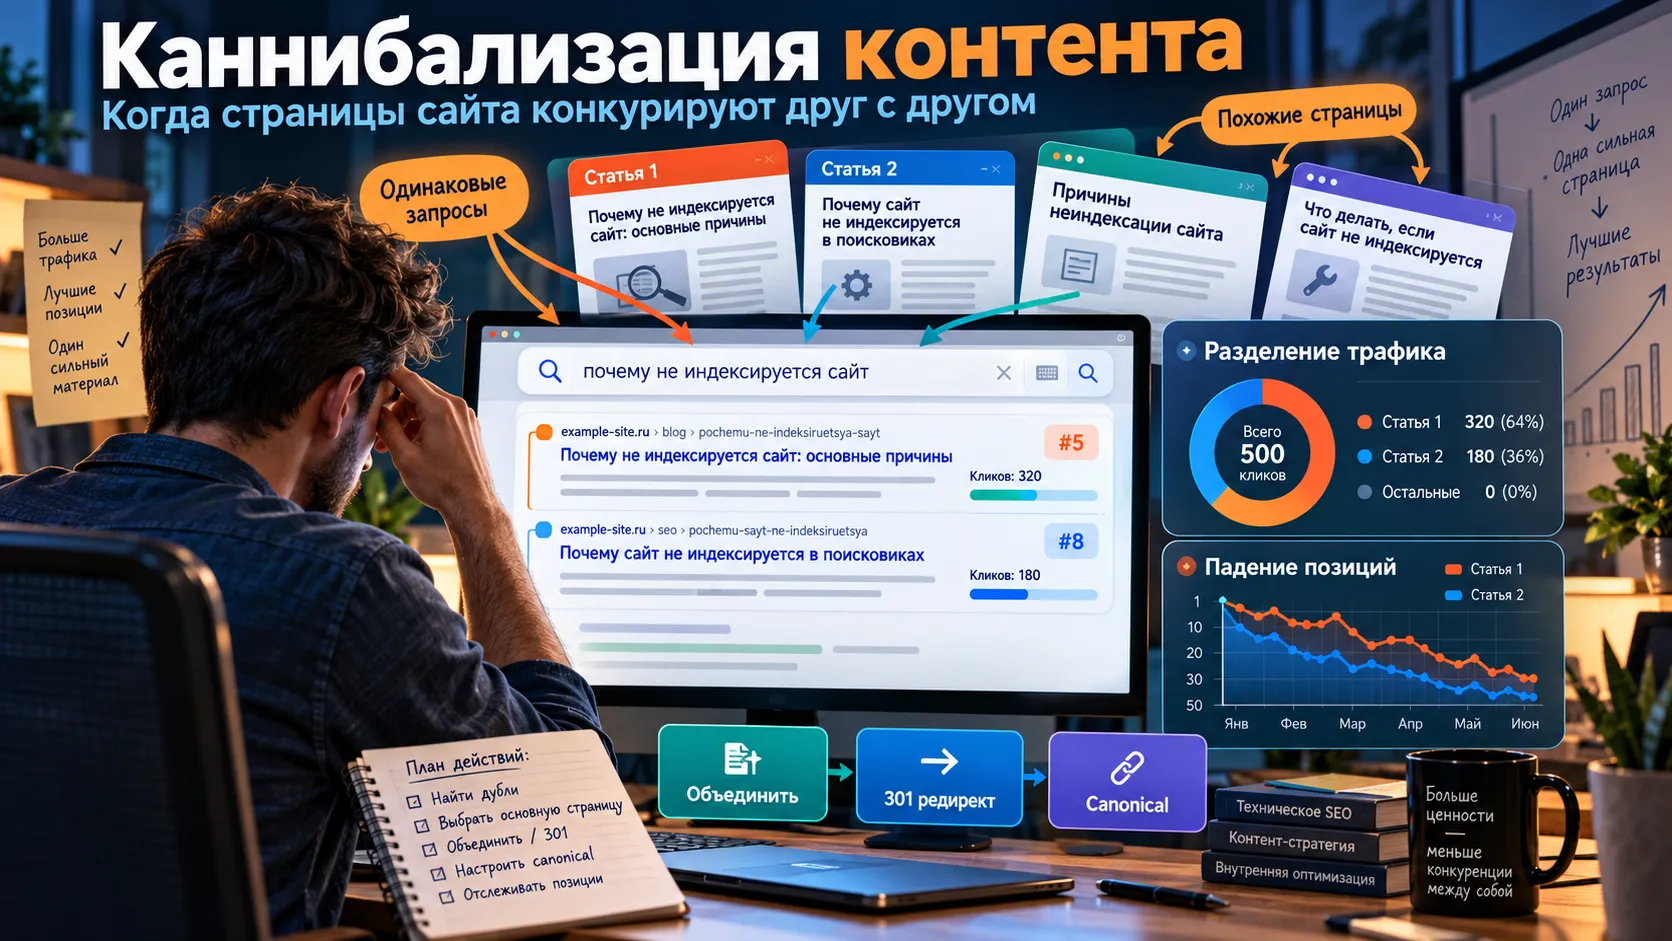
Представим блог о поисковой оптимизации. В нём опубликованы материалы «Почему Google не индексирует страницы», «Причины отсутствия сайта в индексе Google» и «Как исправить проблемы с индексацией». Во всех трёх подробно описаны одни и те же причины: запрет на индексирование, ошибки сервера, дубли URL и проблемы с качеством контента.
Для читателя разница между публикациями почти незаметна. Каждая обещает ответить на одинаковый вопрос. Поисковая система тоже может считать несколько URL подходящими для одного запроса и показывать их в разное время. В SEO такую ситуацию называют каннибализацией контента или каннибализацией ключевых слов.
У явления нет универсального признака вроде «два одинаковых ключа в заголовках». Пересечение запросов само по себе допустимо: поисковики оценивают содержание страницы и её соответствие намерению пользователя. Проблема появляется, когда материалы практически заменяют друг друга, а продвижение нужного URL становится нестабильным или слабым.
Каннибализация может проявляться в блоге, каталоге товаров, разделе услуг, базе знаний и даже между главной страницей и посадочной страницей конкретной услуги.
Совпадение ключевых слов ещё не означает проблему
Главный критерий — поисковое намерение, или интент: какую задачу человек хочет решить, вводя запрос. Один и тот же термин может встречаться на десятках страниц, посвящённых разным вопросам.
| Страницы | Намерение пользователя | Оценка пересечения |
| «Что такое eSIM» и «Как подключить eSIM на iPhone» | Узнать принцип работы и выполнить настройку | Два самостоятельных материала |
| «Почему Google не индексирует сайт» и «Причины отсутствия страниц в Google» | Найти причины проблем с индексацией | Вероятное пересечение намерений |
| «Ноутбуки Lenovo» и «Ноутбук Lenovo ThinkPad X1» | Выбрать линейку товаров и изучить конкретную модель | Разные уровни выбора |
| «Купить кондиционер в Москве» и «Продажа кондиционеров в Москве» | Найти продавца и оформить покупку | Возможная конкуренция двух посадочных страниц |
Эта таблица показывает принцип анализа, а не результаты исследования конкретного сайта. Окончательный вывод зависит от реального содержимого страниц и выдачи по целевым запросам.
Особенно внимательно стоит рассматривать материалы, которые различаются преимущественно названием, порядком абзацев или набором синонимов. Если после прочтения любой из двух статей пользователь получает практически одинаковый ответ, у страниц может отсутствовать самостоятельная задача.
Чередование URL в выдаче помогает обнаружить каннибализацию
Один из характерных сигналов — смена страницы, которая получает показы по важному запросу. Например, сначала поисковик показывает подробный гайд, затем короткую заметку, а спустя неделю снова возвращает гайд.
Другие поводы для проверки:
- По целевому запросу появляются два или больше URL с очень похожим содержанием.
- Нужная посадочная страница теряет показы, а их получает соседняя статья.
- Разные страницы собирают одинаковые поисковые фразы, хотя их назначение почти совпадает.
- Внутренние ссылки ведут на несколько равнозначных материалов с похожими анкорами.
- После публикации новой статьи старая теряет часть запросов, а суммарные клики по теме не растут.
Ни один признак не доказывает каннибализацию отдельно. Позиции меняются из-за обновлений поисковых систем, действий конкурентов, сезонности, устройства пользователя и региона. Две страницы одного сайта могут успешно появляться по одному запросу, если каждая даёт самостоятельную пользу.
Технические дубли и смысловые пересечения требуют разных решений
Поисковые системы умеют группировать одинаковые и очень похожие страницы. Google называет выбор представительного URL каноникализацией, а Яндекс описывает объединение страниц в группы дублей. В документации Google отдельно сказано, что наличие дублирующегося контента на сайте само по себе не нарушает правила борьбы со спамом.
Технический дубль возникает, когда один материал доступен по нескольким адресам: с параметрами сортировки, UTM-метками, разными путями или версиями URL. В такой ситуации обычно требуется определить предпочтительный адрес.
Смысловое пересечение возникает, когда по разным адресам опубликованы самостоятельные тексты, но они повторяют друг друга по содержанию и цели. Здесь главный вопрос связан с редакционной структурой: нужны ли читателю обе публикации и какую отдельную задачу решает каждая.
Поэтому простая замена title, description или H1 редко решает проблему глубоко пересекающихся статей. Меняется оформление страницы, а содержание остаётся прежним.
Google Search Console показывает, какие URL получают показы по одному запросу
Для первичной диагностики подойдёт бесплатная Google Search Console. В отчёте эффективности поиска можно выбрать запрос и увидеть страницы, которые Google показывал пользователям.
- Откройте «Эффективность» → «Результаты поиска» и установите период, например последние три месяца.
- Включите показатели «Клики», «Показы», CTR и «Средняя позиция».
- Перейдите на вкладку «Запросы» и выберите фразу, важную для сайта.
- После применения фильтра откройте вкладку «Страницы». Здесь появятся URL, получавшие показы по выбранной фразе.
- Сравните страницы по кликам и показам, затем проверьте динамику за разные интервалы времени.
- Откройте найденные URL и сравните их содержание, заголовки, интент и внутренние ссылки.
Для группы близких фраз можно использовать фильтр с регулярным выражением. Например, (индексация|индексирование) помогает изучить запросы с любым из этих слов. Такой фильтр ищет совпадения в тексте запросов; он не умеет автоматически определять одинаковый смысл разных формулировок.
Данные Search Console требуют аккуратного чтения. При группировке по сайту и по страницам показатели считаются по-разному. Кроме того, часть запросов может отсутствовать в таблицах из-за ограничений отчётности и конфиденциальности. Отсутствие URL в выгрузке ещё не доказывает, что он никогда не конкурировал с другой страницей.
Если Google исключил URL как дубль, откройте инструмент «Проверка URL». Он помогает увидеть канонический адрес, выбранный владельцем сайта, и канонический адрес, выбранный Google.
Яндекс Вебмастер позволяет сопоставить запросы и посадочные страницы
В Яндекс Вебмастере полезны отчёты раздела «Эффективность». «Статистика поисковых запросов» показывает динамику показов и кликов, а «Статистика страниц» — показатели отдельных URL.
Для более точного сопоставления запросов и страниц предназначена «Эффективность» → «Расширенная аналитика поисковых запросов по URL (β)». Сервис позволяет задать диапазон дат, регион и список URL, затем получить CSV с запросами, показами, кликами и позициями. У инструмента есть лимиты на выгрузки.
Практический порядок проверки похож на Google:
- Найдите два или несколько материалов, претендующих на общую тему.
- Посмотрите, какие запросы и показы получает каждый URL.
- Сравните периоды до публикации нового материала и после неё.
- Проверьте, не исключена ли целевая страница из поиска как дубль.
- Откройте саму поисковую выдачу в нужном регионе и посмотрите, какие ответы она предлагает пользователям.
В отчётах Яндекса могут действовать ограничения по числу отображаемых страниц и запросов. В «Статистике страниц», согласно справке сервиса, доступны первые 3000 страниц сайта, попадавших не ниже 50-й позиции. Поэтому большой сайт удобнее анализировать по тематическим группам URL.
Карта запросов помогает закрепить за темой основную страницу
После сбора данных удобно составить простую таблицу: поисковый запрос, предполагаемая цель пользователя, основной URL, пересекающиеся URL и действие с каждым из них.
| Группа запросов | Основная страница | Пересекающаяся страница | Возможное решение |
| Причины отсутствия страниц в Google | Подробный гайд по индексации | Старый обзор с теми же причинами | Объединение материалов |
Настройка robots.txt | Отдельная инструкция | Гайд по индексации | Сохранить обе, уточнить назначение |
| Проверка статуса индексации URL | Инструкция по Search Console | Общий материал о SEO | Уточнить содержание и внутренние ссылки |
| Один товар с двумя одинаковыми URL | Карточка с постоянным адресом | Копия карточки с параметром | Каноникализация или перенаправление |
Основная страница должна соответствовать ключевому намерению пользователя. При выборе учитывают полноту материала, релевантность, текущие показы и клики, полезные обратные ссылки, актуальность и место URL в структуре сайта. Сохранение старого адреса может быть оправданно его историей, если на нём уже есть трафик и ссылки.
Объединение материалов и редирект 301 подходят для заменяемых публикаций
Когда две статьи дают практически одинаковый ответ, их можно свести к одному материалу. Сильные разделы обеих публикаций собирают в основной статье, убирают повторы и приводят структуру к единому поисковому намерению.
Если вторую страницу окончательно выводят из использования и для её посетителей есть содержательно подходящая новая страница, настраивают постоянный редирект 301. Google рассматривает такой редирект как сильный сигнал при выборе канонического адреса. Перенаправление на случайную категорию или главную страницу может привести пользователя к неподходящему содержимому.
После объединения обновляют внутренние ссылки, хлебные крошки и Sitemap. Исторический адрес может сохраняться в таблице переадресаций, чтобы старые ссылки продолжали работать.
Разделение интентов сохраняет полезные страницы
Два материала могут касаться одной темы и оставаться самостоятельными. Например, «Почему Google не индексирует страницу» отвечает за диагностику причин, а «Как проверить индексацию в Google Search Console» описывает конкретный инструмент.
В таком случае переработка строится вокруг чётких границ: в общем гайде остаётся краткое объяснение проверки, в отдельной инструкции — последовательность действий, интерфейс и разбор результатов. Между материалами добавляют понятные внутренние ссылки.
Так формируется тематический кластер: обзорная страница помогает выбрать направление, а узкие инструкции подробно решают отдельные задачи. Внутренние анкоры отражают содержимое целевых страниц.
rel="canonical" используется для дублей и очень похожих URL
Когда один документ доступен по нескольким адресам, можно указать предпочтительную версию через элемент HTML:
<link rel="canonical" href="https://example.com/blog/indexing-guide/">Google и Яндекс рассматривают такой сигнал при выборе канонического адреса, но могут предпочесть другой URL. Для сильно различающихся по смыслу и содержанию страниц canonical часто оказывается неподходящим инструментом. В справке Яндекса прямо указано, что робот может проигнорировать атрибут при существенном расхождении содержимого.
Для страниц, которые должны самостоятельно участвовать в поиске, обычно используют канонический адрес на саму страницу. Массовое указание canonical на главную статью для всех публикаций одной категории может исключить из поиска полезные материалы.
noindex и удаление требуют проверки роли страницы
Тег noindex запрещает показ страницы в поддерживающих его поисковых системах после обработки роботом. Для сохранения основного URL среди дублей Google рекомендует использовать подходящий сигнал каноникализации. Применение noindex к полезной статье может лишить её всего органического трафика.
Удаление страницы без подходящей замены приводит к ответу 404 или 410. Такой вариант бывает уместен для окончательно утратившего актуальность содержимого. Если материал получает внешние ссылки, трафик или отвечает на отдельный запрос, последствия удаления требуют отдельной оценки.
Порядок исправления каннибализации на действующем сайте
Всю работу удобно разделить на семь этапов:
- Собрать список URL из Sitemap, CMS или краулера и отметить страницы с близкими темами.
- Выгрузить запросы и показатели из Google Search Console и Яндекс Вебмастера за достаточно длинный период.
- Сгруппировать запросы по намерениям — информационным, коммерческим, навигационным и конкретным действиям.
- Сопоставить интенты со страницами и отметить случаи, где несколько URL обещают один результат.
- Выбрать действие для каждой группы: оставить без изменений, переработать, объединить с 301 или устранить технический дубль.
- Привести структуру сайта к выбранной схеме: обновить тексты, ссылки, канонические адреса, Sitemap и переадресации.
- Сравнить результаты после переобхода с исходным периодом, отдельно по запросам и целевым страницам.
Для примера: если раньше по запросу «ошибки индексации Google» показывались /blog/google-index/ и /blog/indexing-errors/, после объединения основной страницей может стать /blog/google-index/. Выбор адреса зависит от собранных данных. В анализе после изменений смотрят, сохранились ли клики по тематической группе запросов, выросла ли видимость нужного материала и исчезли ли нежелательные технические дубли.
Поисковым системам нужно время на повторный обход и обработку изменений. Google предупреждает, что при переносе URL видимость может временно колебаться; для сайтов среднего размера обработка значительной части переноса иногда занимает несколько недель. Гарантированного срока восстановления позиций нет.
Поспешное удаление и одинаковые шаблоны заголовков создают новые проблемы
В борьбе с пересечениями встречаются несколько ошибок:
- Удаление страниц только за общий ключевой запрос. У URL могут быть разные интенты и самостоятельный трафик.
- Массовая установка
canonicalна одну публикацию. Поисковик может исключить полезные узкие статьи из выдачи. - Редирект всех старых материалов на главную. Посетитель перестаёт получать ожидаемый ответ; Google советует избегать перенаправлений на нерелевантные страницы.
- Исправление только
titleи H1. Повторяющийся основной контент продолжает решать ту же задачу. - Оценка результата по одной позиции за один день. Позиция зависит от множества условий, а данные в отчётах могут агрегироваться по-разному.
- Блокировка дублей только через
robots.txt. Google отдельно указывает, что такой файл не предназначен для выбора канонического URL.
Для редакционных сайтов полезна карта публикаций: одна строка на материал с главным намерением, основными запросами, URL и связанными статьями. Она делает пересечения заметными ещё на этапе планирования нового текста и упрощает обновление старых гайдов.
Источники:
- Google Search Central — выбор канонического URL и сигналы каноникализации
- Google Search Console — просмотр страниц, показанных по выбранному запросу
- Google Search Console — особенности группировки статистики
- Google Search Central — перенос URL и постоянные переадресации
- Яндекс Вебмастер — расширенная аналитика запросов по URL
- Яндекс Вебмастер — канонический адрес страницы
- Яндекс Вебмастер — чем плохи дубли
Каннибализация становится заметной через связь запросов, страниц и результатов
Число страниц на одну тему само по себе ничего не говорит о проблеме. Её наличие определяется тем, насколько материалы повторяют поисковое намерение, какие URL поисковики выбирают для показа и как меняются клики по соответствующей группе запросов.
Объединение публикаций сокращает число близких URL; разделение интентов сохраняет самостоятельные ответы; каноникализация помогает поисковым системам разобраться с дубликатами. Эффект каждого изменения зависит от качества содержимого, истории страниц, поведения поисковых систем и конкурентной выдачи.