16 ноября 2026 года Alibaba представила Qwen4-Max - флагманскую ИИ-модель нового поколения с контекстом на миллион токенов, пониманием изображений и видео и доступом через API. По внутренним тестам компании, она тратит меньше вычислительных ресурсов на сложные задания, а стоимость одного задания в оценке Work360 снизилась на 62% по сравнению с Qwen3.8-Max. Разбираемся, какие изменения подтверждены и чем полноценный запуск отличается от предварительной версии.
Qwen4-Max дешевле выполняет длительные задачи — что показали тесты Alibaba
Снижение расходов стало одним из главных аргументов нового релиза. В собственном тестировании Work360 команда Qwen получила среднюю стоимость выполнения задания $1,67 против $4,43 у Qwen3.8-Max — разница составляет 62%. Work360 охватывает профессиональные сценарии: работу с документами, программирование, анализ данных и задачи, где модели приходится последовательно пользоваться несколькими инструментами.
Разработчики отдельно измеряли количество токенов — небольших фрагментов текста, которые ИИ получает или генерирует при работе. По их данным, расход токенов на Work360 сократился примерно на 24% при максимальной и на 35% при высокой интенсивности рассуждений. В тесте Terminal-Bench 4.0, связанном с работой в терминале и программированием, снижение достигло 48–49%.
Эти показатели отражают методику испытаний Alibaba. Они не гарантируют такую же экономию в каждом проекте: итоговая сумма зависит от длины запросов и ответов, выбранного режима рассуждений, числа повторных попыток и использования кэша.
Новая модель получила и более низкий публичный тариф API. Для международного региона Alibaba Cloud в Сингапуре стоимость составляет $1,50 за миллион входных токенов и $4,50 за миллион выходных. У Qwen3.8-Max в той же тарифной таблице указаны $2 и $6 соответственно. Таким образом, базовые ставки на ввод и вывод уменьшились на 25%. Чтение уже закэшированного контекста Qwen4-Max стоит $0,075 за миллион токенов в этом регионе.
В архитектуре Qwen4 активируется 71 млрд параметров вместо 95 млрд
Qwen4-Max построена на архитектуре Mixture of Experts (MoE) — системе из множества специализированных вычислительных блоков. При обработке очередного фрагмента запроса она использует только часть этих блоков. Это помогает не задействовать всю огромную модель для каждого шага работы.
В основе Qwen4-Max находятся 2,4 трлн параметров, а на один токен активируется около 71 млрд. Для сравнения, Qwen3.8-Max при аналогичном общем масштабе задействовала 95 млрд. Команда также сообщает о дополнительных 328 млрд параметров в механизме N-gram Embedding, который помогает обрабатывать повторяющиеся последовательности элементов текста.
В новой архитектуре переработали способы хранения контекста и передачи информации между слоями. Механизмы Gated DeltaNet и Qwen Sparse Attention позволяют модели сжимать часть истории и точечно обращаться к нужным фрагментам длинного контекста. Gated Residual регулирует передачу данных между вычислительными слоями. Alibaba связывает с этими изменениями более экономную обработку информации и стабильность обучения.
Зачем это пользователю? Например, агенту, который меняет интерфейс приложения, нужно помнить требования, читать код, сопоставлять скриншоты и несколько раз исправлять результат. Чем меньше ресурсов уходит на каждый промежуточный шаг, тем ниже потенциальная стоимость такого рабочего процесса.
Контекст на миллион токенов помогает анализировать код, документы и видео
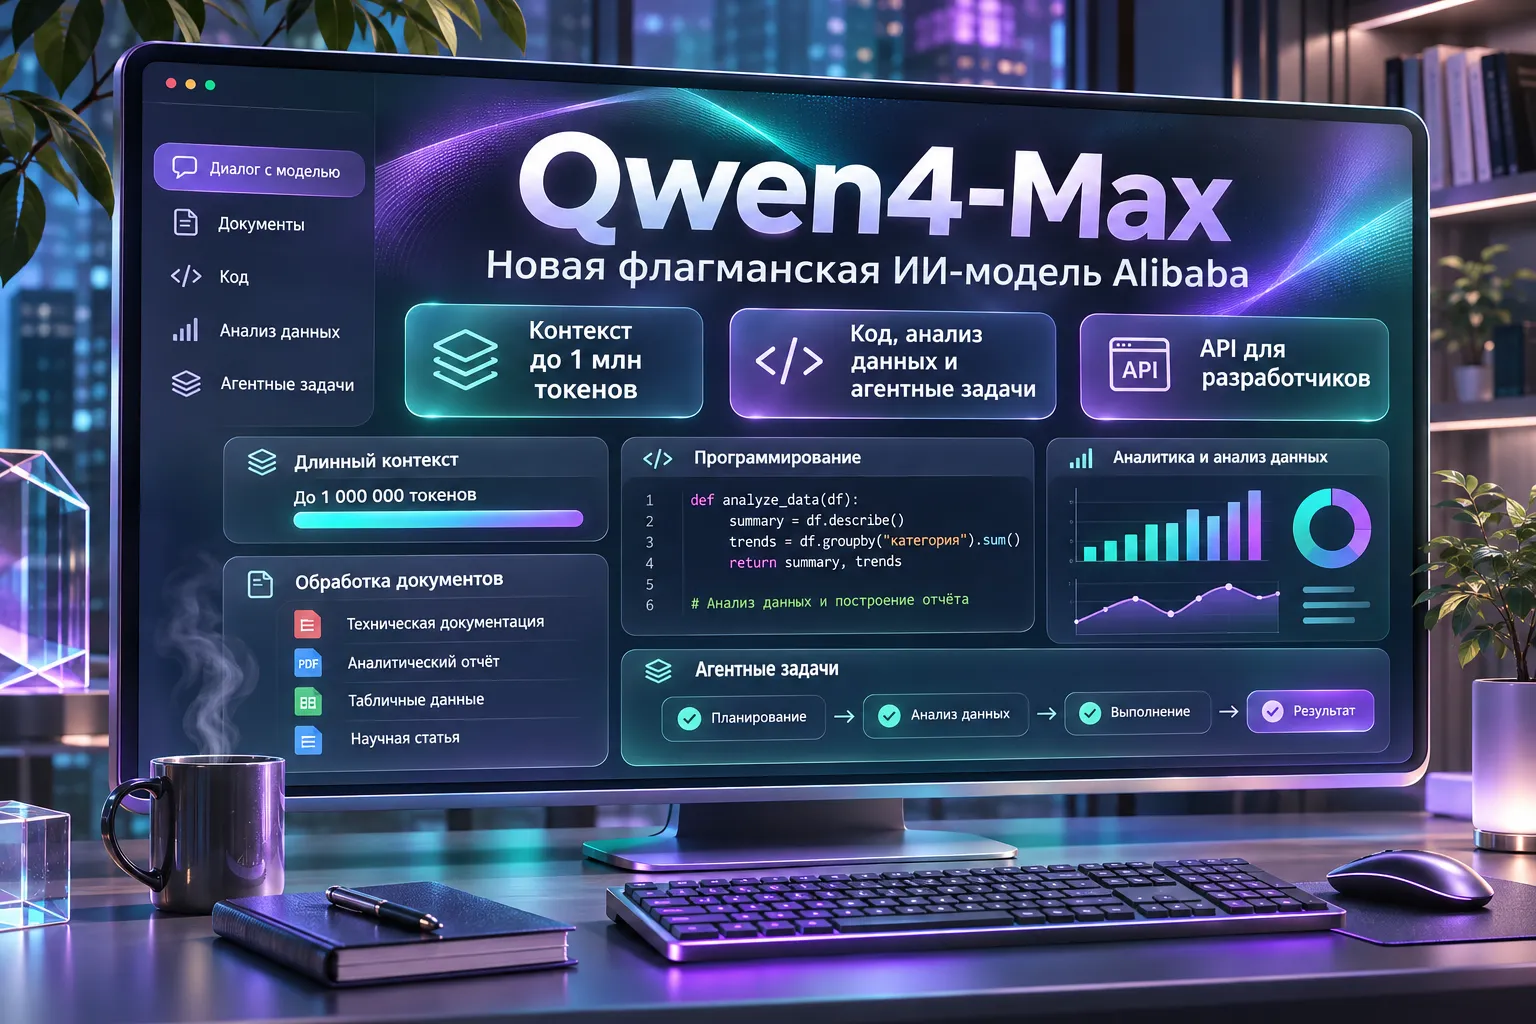
Qwen4-Max принимает текст, изображения и видео, а ответы формирует в текстовом виде. Контекстное окно достигает 1 млн токенов — это объём информации, который модель может учитывать в пределах одного запроса. Большой контекст удобен для изучения крупных проектов, набора договоров, технической документации и материалов, где сведения разбросаны по многим файлам.
Миллион токенов был доступен и в Qwen3.8-Max. Поэтому при сравнении поколений существеннее новые механизмы обработки контекста, эффективность выполнения заданий и тарифы. Сам размер окна ещё не доказывает, что модель безошибочно найдёт любую деталь в огромном архиве.
Через Alibaba Cloud Model Studio доступны вызовы внешних инструментов (Function Calling), веб-поиск и структурированные ответы, например в формате JSON. Поддерживаются интерфейсы, совместимые с OpenAI Chat Completions, Responses и Anthropic Messages. Это позволяет использовать модель в приложениях, которые уже работают с подобными протоколами, хотя особенности параметров и вывода всё равно определяются документацией Qwen4-Max.
У модели есть режим расширенных рассуждений. Согласно документации Alibaba Cloud, без него максимальный ответ составляет 131 072 токена, а при включённых рассуждениях общий бюджет на внутреннюю обработку и ответ достигает 262 144 токенов. Эти ограничения отличаются от размера входного контекста и влияют на то, сколько информации модель может выдать за один вызов.
Live Delivery позволяет контролировать длинные агентные задания поэтапно
Вместе с запуском Qwen4-Max команда показала подход Live Delivery для задач, которые занимают много шагов. Идея проста: агент сначала выдаёт пригодный для проверки промежуточный результат, затем развивает его с учётом обратной связи. Пользователь может увидеть рабочую версию до окончания всего проекта и уточнить требования по ходу выполнения.
Разработчики опубликовали Qwen-Live-Delivery-Plugin с открытым исходным кодом. Репозиторий описывает механизм промежуточных версий, получение замечаний и сохранение результатов этапов. В опубликованной реализации поддерживается Codex CLI. Плагин организует рабочий процесс агента отдельно от непосредственных вызовов Qwen4-Max через API.
Alibaba демонстрирует Qwen4-Max в создании трёхмерных сцен Blender, разработке игр на Unity и Unreal Engine и подготовке профессиональных документов. Это примеры компании, поэтому их следует отделять от независимой оценки качества реальных проектов.
Qwen4-Max уже доступна через API — чем запуск отличается от Preview
11 ноября 2026 года Alibaba открыла ограниченную Qwen4-Max-Preview с идентификатором qwen4-max-preview. Доступ к ней предоставлялся через подписку Token Plan. Документация указывает, что предварительная модель действует до 25 ноября и затем будет выведена из использования.
16 ноября появилась полноценная модель с отдельным идентификатором qwen4-max. Её можно вызывать через Alibaba Cloud Model Studio с оплатой по объёму токенов. Компания также назвала Qwen Studio, QwenWork и инструмент разработки Qoder среди способов знакомства с новым флагманом.
Для интеграций разница между двумя идентификаторами принципиальна. Предварительный вариант привязан к ограниченному периоду и условиям Token Plan, тогда как у Qwen4-Max опубликованы отдельные параметры модели, региональные тарифы и доступ через обычный API. В некоторых регионах условия и расценки отличаются от международного тарифа Сингапура.
Младшие модели Qwen4 получат открытые веса, сроки пока не объявлены
Qwen4-Max стала первым представленным флагманом новой серии. Alibaba сообщила о намерении выпустить более компактные модели Qwen4 с открытыми весами — файлами, которые позволяют запускать модель на собственной инфраструктуре при выполнении условий её лицензии. Для самой Qwen4-Max открытая публикация весов в анонсе не объявлена; облачная документация не предусматривает самостоятельное развёртывание этой модели.
Пока неизвестны даты выпуска компактных вариантов, их характеристики и лицензии. Уже подтверждённое отличие Qwen4-Max от предыдущего флагмана связано с новой архитектурой, меньшим расходом токенов в тестах Alibaba и более дешёвым облачным API. Как эта экономия проявится в независимых испытаниях длительных агентных задач, покажут результаты сторонних проверок.
Источники
- Qwen Team — Qwen4-Max: Your New Teammate Has Arrived (16 ноября 2026 года)
- Alibaba Cloud Model Studio — Qwen4-Max, возможности и ограничения
- Alibaba Cloud Model Studio — тарифы моделей Qwen
- Qwen Team — Qwen3.8-Max: A New Bar for Coding and Cowork (для сравнения)
- QwenLM — Qwen-Live-Delivery-Plugin на GitHub