Мониторинг PostgreSQL помогает увидеть, что происходит с базой данных сейчас и как её состояние менялось во времени: какие запросы потребляют ресурсы, где возникают блокировки, как ведут себя соединения, дисковый ввод-вывод, индексы и фоновые процессы. Для рабочих систем ценность появляется тогда, когда технические метрики связываются с историей нагрузки и конкретными событиями в приложении.
PostgreSQL уже содержит много данных о собственном состоянии
PostgreSQL собирает внутреннюю статистику работы сервера и предоставляет её через системные представления. Администратор может увидеть активные сеансы, длительность запросов, число подключений, состояние репликации, работу фоновых процессов, интенсивность чтения и записи, активность таблиц и индексов.
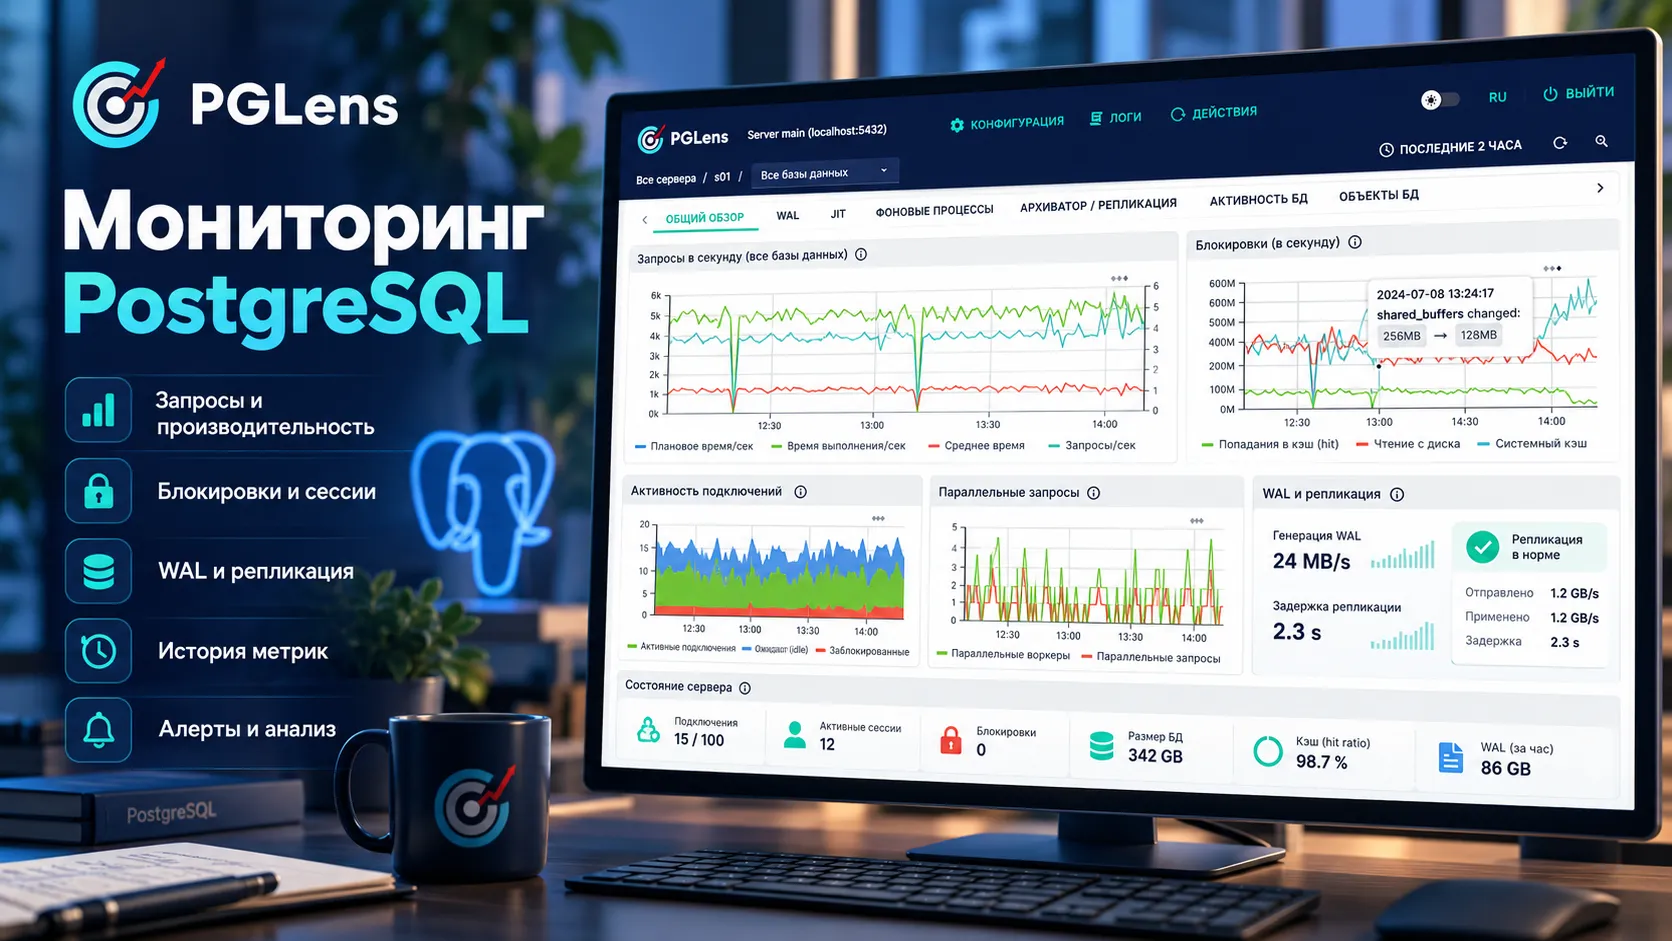
На этом же принципе строятся специализированные системы наблюдения за СУБД. Например, мониторинг PostgreSQL в PGLens включает сбор и историзацию показателей, анализ медленных запросов, сессий и блокировок, статистику использования индексов и сравнение состояния базы до и после изменений. Для инфраструктуры с ограничениями на передачу технических данных у сервиса предусмотрен вариант развертывания on-premise, а также формат PaaS.
Одна из основных точек наблюдения — pg_stat_activity. В ней видны текущие подключения к серверу, состояние сеансов, выполняемые запросы и время начала операций. Когда приложение внезапно начинает отвечать медленнее, эта информация помогает понять, есть ли длинные запросы, зависшие транзакции или большое число соединений в состоянии idle.
Представление pg_stat_database показывает статистику на уровне базы: количество транзакций, откаты, чтение блоков, попадания в буферный кеш и другие накопительные показатели. Для оценки ввода-вывода в современных версиях PostgreSQL используется pg_stat_io, где статистика разбита по типам процессов, объектам и контекстам операций.
Отдельный слой наблюдения связан с обслуживанием базы. Через представления прогресса PostgreSQL показывает выполнение VACUUM, CREATE INDEX, ANALYZE, COPY, резервного копирования и других длительных операций. Это особенно полезно на крупных базах, где фоновая работа может занимать минуты или часы.
Статистика запросов показывает, куда уходит время базы данных
Текущий список запросов отвечает на вопрос о происходящем в конкретную секунду. Для анализа нагрузки за период требуется накопленная статистика. В PostgreSQL эту задачу решает расширение pg_stat_statements.
Расширение учитывает статистику планирования и выполнения SQL-запросов. По накопленным данным можно увидеть запросы с большим суммарным временем выполнения, высокой частотой запуска, значительным чтением данных или большим средним временем ответа.
Такой список часто оказывается полезнее поиска одного «медленного запроса». Запрос длительностью 300 миллисекунд, который выполняется несколько сотен тысяч раз, способен создать больший вклад в нагрузку, чем редкая операция на несколько секунд. Мониторинг помогает смотреть на сочетание времени, частоты и потребления ресурсов.
Для разработчиков это связывает производительность базы с конкретным кодом приложения. После нового релиза может вырасти число одинаковых запросов, измениться план выполнения или увеличиться объём чтения. История метрик позволяет сопоставить момент изменения приложения и момент изменения нагрузки на PostgreSQL.
Блокировки и соединения часто объясняют внезапные задержки
База может иметь свободный CPU и быстрые диски, а приложение всё равно будет ждать. Одна из распространённых причин — конкуренция транзакций за блокировки.
PostgreSQL публикует текущие блокировки через pg_locks. В связке с pg_stat_activity можно определить, какая сессия ждёт ресурс, какая транзакция удерживает блокировку и сколько времени продолжается ожидание. Подобная картина возникает, например, когда одна транзакция долго изменяет строки, а другая пытается работать с теми же объектами.
Отдельной проблемой становится управление соединениями. Каждое подключение к PostgreSQL связано с серверным процессом и расходует ресурсы. Резкий рост числа соединений может появиться после увеличения нагрузки на приложение, сбоя пула соединений или изменения конфигурации сервисов.
Поэтому в рабочем мониторинге обычно отслеживают число активных и простаивающих сеансов, длительные транзакции, ожидания, ошибки подключения и приближение к лимиту max_connections. Эти показатели дают контекст, которого недостаточно у одной метрики загрузки CPU.
Диски, память и WAL связывают работу PostgreSQL с инфраструктурой
Производительность СУБД зависит от сервера, на котором она работает. Если заканчивается свободное место, растёт задержка дисковых операций или система испытывает давление по памяти, это быстро отражается на времени выполнения запросов.
Для PostgreSQL полезна совместная картина из внутренних и системных метрик. Внутри СУБД можно отслеживать чтение и запись, работу буферного кеша, WAL, контрольные точки, репликацию и фоновые процессы. На уровне операционной системы видны CPU, память, задержка дисков, файловые системы и сеть.
WAL — журнал предзаписи, через который PostgreSQL обеспечивает надёжность изменений и работу репликации. Рост объёма WAL может сопровождать массовые изменения данных, интенсивную запись или отдельные операции обслуживания. В реплицируемых системах контролируют состояние реплик, задержку воспроизведения и состояние replication slots, поскольку накопление WAL способно занимать всё больше дискового пространства.
Мониторинг диска в таком сценарии связан с конкретной цепочкой событий: рост WAL, увеличение занятого пространства, задержка реплики, ограничение свободного места. Изолированный график диска показывает симптом, а связанные метрики базы помогают восстановить причину.
История метрик превращает наблюдение в анализ инцидента
Многие системные представления PostgreSQL описывают текущее состояние или накопительные счётчики. После завершения блокировки, закрытия проблемной сессии или перезапуска сервиса часть контекста исчезает. Для разбора ночного сбоя одной проверки базы утром уже мало.
Поэтому системы мониторинга сохраняют значения метрик во внешнем хранилище и строят временные ряды. В результате можно открыть интервал до инцидента, во время него и после восстановления. Так становится видно, когда выросло число соединений, какой запрос увеличил нагрузку, как изменилось время операций ввода-вывода и совпало ли событие с развёртыванием новой версии приложения.
Историчность полезна и без аварии. После изменения параметров PostgreSQL, добавления индекса или релиза приложения можно сравнить одинаковые периоды нагрузки. Такой анализ показывает, изменилось ли среднее время запросов, число операций чтения, количество блокировок и суммарная нагрузка.
Алерты фиксируют момент, когда метрика выходит за рабочий диапазон
Панель мониторинга показывает состояние системы человеку, который уже открыл её. Алертинг нужен для другого сценария: система сама фиксирует заданное условие и отправляет уведомление.
Триггером может быть заполнение диска, рост числа соединений, длительная блокировка, отставание реплики, увеличение времени выполнения запросов или всплеск ошибок. Само значение порога зависит от архитектуры и обычного профиля нагрузки. Для одной базы 100 активных соединений штатны, для другой такое число уже сопровождается деградацией.
Полезный алерт содержит контекст: имя экземпляра, базу данных, время начала события, текущее значение показателя и связанный объект. Уведомление вида «CPU 90%» оставляет много вариантов причины. Сообщение о росте CPU одновременно с конкретной группой SQL-запросов и увеличением чтения с диска сокращает область поиска.
Избыточное число оповещений создаёт другую проблему — команда перестаёт реагировать на поток повторяющихся сообщений. Поэтому мониторинг обычно разделяет информационные события, предупреждения и критические состояния, а пороги уточняются по накопленной истории конкретной системы.
Индексы и планы запросов требуют наблюдения в динамике
Индекс ускоряет доступ к данным только в тех запросах и условиях, для которых планировщик считает его подходящим. Со временем объём таблиц, распределение значений и набор запросов меняются. Индекс, который активно использовался год назад, может почти исчезнуть из реальной нагрузки.
Статистика PostgreSQL позволяет наблюдать обращения к индексам и таблицам. Для анализа отдельных запросов используется EXPLAIN, а EXPLAIN ANALYZE запускает запрос и добавляет фактические данные выполнения. На production-системах такой запуск требует понимания стоимости операции, особенно для запросов, которые изменяют данные или потенциально обрабатывают большой объём строк.
В мониторинговой системе история использования индексов помогает увидеть длительный тренд. Это снижает риск выводов по одному короткому срезу, когда редкий, но важный запрос просто не попал в окно наблюдения.
Отдельный интерес представляет моделирование возможного индекса без физического создания объекта. PGLens описывает функцию симуляции индекса в памяти текущей сессии, которая передаёт планировщику метаданные о предполагаемом индексе и позволяет оценить изменение плана. Это относится к аналитике планирования; фактический эффект реального индекса зависит от данных, нагрузки, стоимости обслуживания и поведения запросов.
Автовакуум и накопление мёртвых строк влияют на стабильность базы
PostgreSQL использует MVCC — механизм многоверсионности, при котором изменение строки создаёт новую версию. Старые версии постепенно становятся ненужными и очищаются процессом VACUUM. Автоматическое обслуживание выполняет autovacuum.
Если обслуживание не успевает за объёмом изменений, таблицы и индексы могут расти, а операции чтения — затрагивать больше страниц. Для диагностики смотрят статистику таблиц, число живых и мёртвых строк, даты последних операций VACUUM и ANALYZE, а также прогресс текущих процессов очистки.
Мониторинг здесь ценен накопленной динамикой. Однократное большое число мёртвых строк может быть связано с пакетной операцией. Постоянный рост в одной таблице указывает на устойчивый профиль изменений, который уже можно сопоставлять с настройками autovacuum и поведением приложения.
Одна метрика редко объясняет деградацию PostgreSQL
Высокая загрузка CPU сама по себе не называет причину. Большое число соединений тоже требует контекста. Медленный запрос может ждать блокировку, читать данные с диска, выполнять тяжёлую сортировку или работать по изменившемуся плану.
Поэтому диагностика строится вокруг связанных сигналов. Время SQL-запросов сопоставляют с ожиданиями, блокировками, дисковым вводом-выводом, состоянием памяти, числом соединений и событиями приложения. Для репликации добавляются задержка и WAL, для больших таблиц — статистика обслуживания и использование индексов.
Такой подход меняет сам характер наблюдения за базой. Панель с десятками графиков превращается в историю конкретного события: в 14:05 вырос поток запросов, затем увеличилось число активных сессий, появилась блокировка, после чего время ответа приложения вышло за обычный диапазон.
Мониторинг становится частью истории работы системы
PostgreSQL предоставляет подробную телеметрию о запросах, транзакциях, блокировках, вводе-выводе, репликации и обслуживании. Специализированные системы добавляют к этим данным хранение истории, визуализацию, корреляцию показателей, отчёты и уведомления.
Чем дольше работает проект, тем полезнее становится контекст прошлых состояний. Одни и те же симптомы могут иметь разные причины, а накопленная история показывает связь между изменениями приложения, конфигурацией базы и поведением инфраструктуры.
Вопрос качества мониторинга в итоге сводится к полноте этой картины: можно ли по сохранённым данным восстановить последовательность событий и объяснить, почему PostgreSQL начал работать иначе в конкретный момент времени.